채팅을 운송 오더로 바꾸는 파이프라인
안녕하세요. 센디 DX 스쿼드에서 외부 채널 접수 자동화를 개발했던 박정환(Lody)입니다.
이 작업에서 저는 서버 분석 API, intent 판정과 초안 변환 호출, 오더 후보 저장, 메시지 처리 상태 관리를 맡았습니다. 이 글은 2026년 10월 당시의 구현을 돌아보며 정리했습니다. 서버 측 공통 오더 식별자로의 전환은 원고를 정리할 때까지 구현되지 않은 상태였습니다.
센디 제품을 사용하지 않는 화주들은 단체 카카오톡으로 운송을 신청했습니다. "내일 오전 9시 상차, 5톤 한 대, 이천에서 횡성" 같은 메시지가 올라오면 운영자가 내용을 읽고 콘솔에 오더를 옮겨 담았습니다. 이 글에서는 카카오톡 수집기가 가져온 메시지를 DX가 서버로 전달하고, 서버가 오더 후보를 만들어 운영자가 확인하는 흐름을 다뤘습니다. 당시 구현 범위에는 다른 채널을 같은 파이프라인으로 처리하는 기능은 포함되지 않았습니다.
처음에는 채널마다 대화를 읽어오는 수집기만 붙이면 될 거라고 생각했습니다. 하지만 규모가 커지면서 두 가지 문제가 드러났습니다.
하나는 정합성이었습니다. 중개형 3PL 고객 한 곳은 하위 화주 수십 곳의 오더를 받아 재배차했습니다. 이들은 화주가 보낸 오더 수와 콘솔에 등록된 오더 수가 맞는지 매일 사람이 손으로 대조했습니다. 대조는 누락과 중복을 사후에 찾는 일이어서, 건수가 늘수록 더 많은 시간이 들었습니다.
다른 하나는 동시성이었습니다. 여러 배차 담당자가 한 대화방을 함께 봤습니다. 같은 메시지 구간을 동시에 분석하거나 이미 만든 후보를 다시 처리하지 않도록 서버가 공통 상태를 관리해야 했습니다.
수기 접수를 자동화하면서 마주친 문제와 기술적 선택을 돌아봤습니다. 각 선택지의 장단점과 이후 운영 비용을 비교해 어떤 결정을 내렸는지 중심으로 정리했습니다. 실제 구현과 당시 설계 단계에 머물렀던 내용을 구분했습니다.
1. 카카오톡 메시지 구간을 분석 단위로 삼기
당시 구현의 입력은 카카오톡 수집기였습니다. 수집기는 대화방의 chatId와 각 메시지의 logId를 전달했습니다. 서버는 chatId와 정렬된 logIds를 SHA-256으로 해시해 segmentKey를 만들었고, 여러 메시지가 오가는 대화 맥락을 하나의 분석 구간으로 다뤘습니다.
이 키는 카카오톡 수집 경로 안에서 입력 구간을 식별했습니다. 카카오톡과 Teams의 원본 ID는 생성 규칙과 범위가 달라질 수 있고, 우연히 같은 값이 만들어질 수도 있습니다. 따라서 이 키를 채널을 넘는 공통 오더 ID로 볼 수는 없었습니다.
2. 여러 실무자가 같은 방을 볼 때의 중복
같은 입력이 동시에 들어오면 판정 API와 변환 API가 중복 호출될 수 있었습니다. 당시에는 카카오톡 수집기의 메시지 ID를 기준으로 처리 상태를 Redis에 두고 서버가 먼저 작업을 선점했습니다.
Redis 선점 상태는 (carrierId, chatId, logId) 조합의 메시지 단위로 관리했습니다. 기본 선점 시간은 60초였고 완료 상태는 72시간 보관했습니다. 후보 DB의 고유 키는 (carrierId, segmentKey, draftIndex)였습니다. 즉, 메시지 처리 선점과 오더 후보 중복 저장은 서로 다른 단위와 키를 사용했습니다.
Redis에 연결할 수 없을 때는 선점에 성공한 것으로 간주하고 처리를 계속하도록 구현했습니다. 이때 같은 메시지에 대한 모델 호출이 겹칠 수 있지만, DB 고유 키는 같은 구간 후보의 중복 저장을 막았습니다. Redis 선점이 장애 상황에서도 정확히 한 번의 분석을 보장하지는 않았습니다.
- 이미 선점된 메시지는 다른 요청에서 다시 처리하지 않고
IN_PROGRESS를 반환했습니다. - 완료 상태는
ORDER,NOT_ORDER,FILTERED로 나눴고, 실패는 재시도 정책을 적용할 수 있도록 별도로 남겼습니다. - 후보 DB 고유 키는 운송사·구간 키·초안 순번이었습니다. 이는 같은 구간을 다시 저장하는 것을 막는 기준이었으며, 구간이 다르거나 채널이 달라진 동일 오더를 의미 기반으로 찾아내지는 못했습니다.
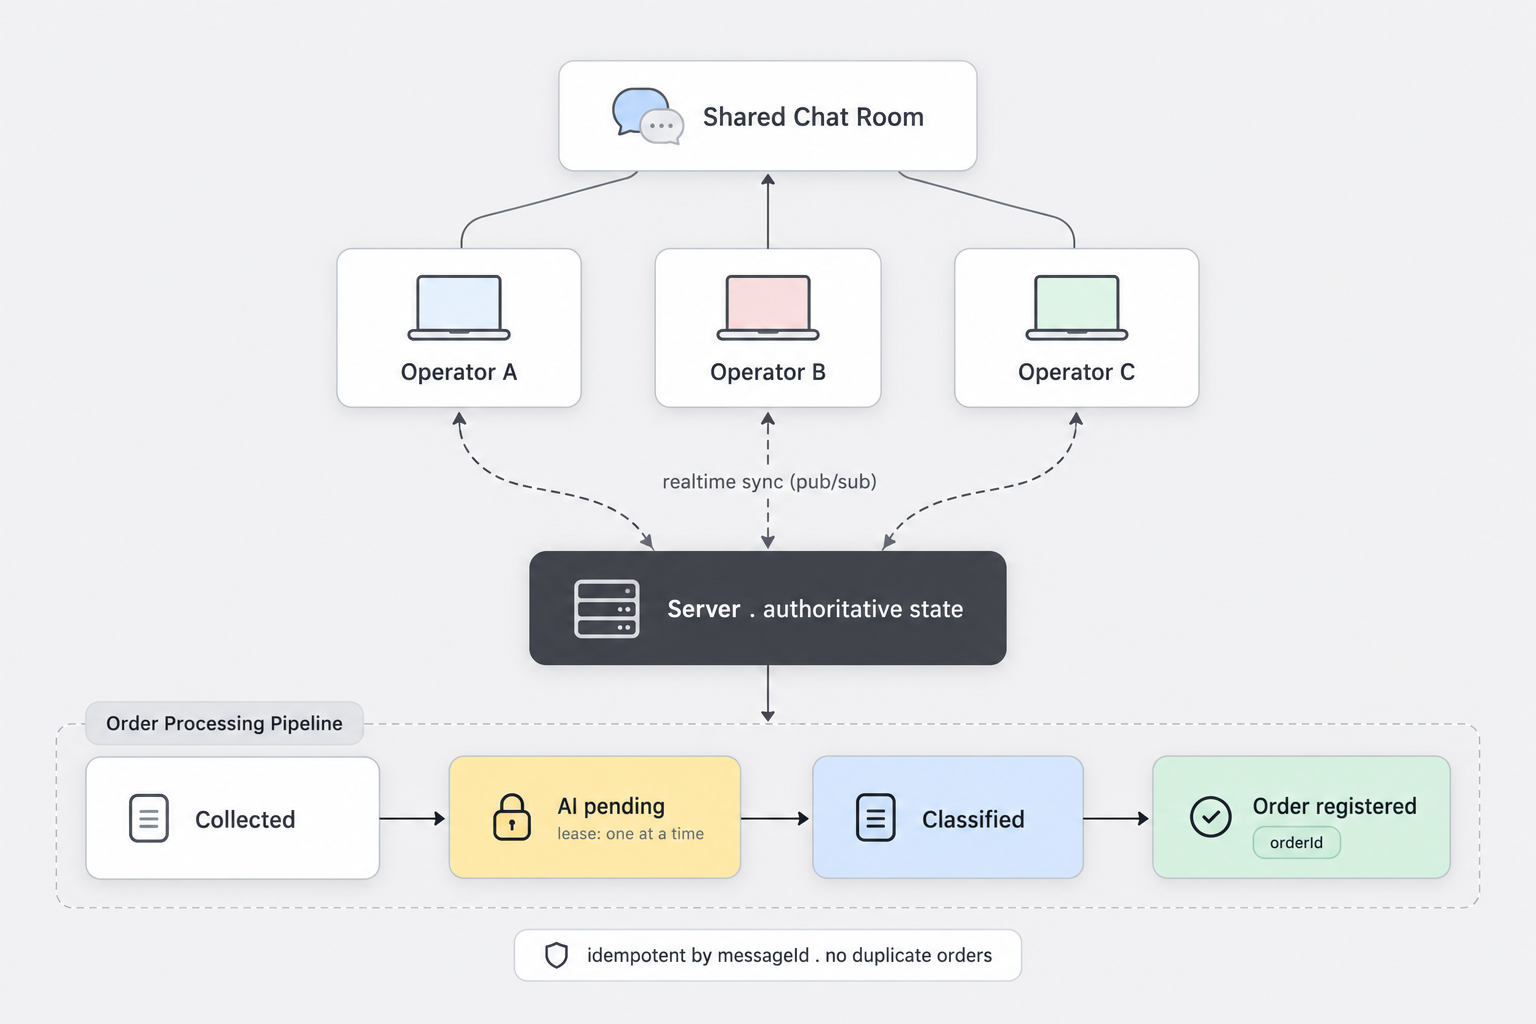
이 구조의 목적은 매일 하던 수기 대조 부담을 줄이는 것이었습니다. Redis 선점은 같은 메시지의 동시 분석을 제어했고, 후보 DB 키는 같은 구간의 재저장을 막았습니다. 서로 다른 구간이나 채널 사이의 중복은 별도 문제로 남았습니다.
3. intent 판정과 오더 초안 변환 분리
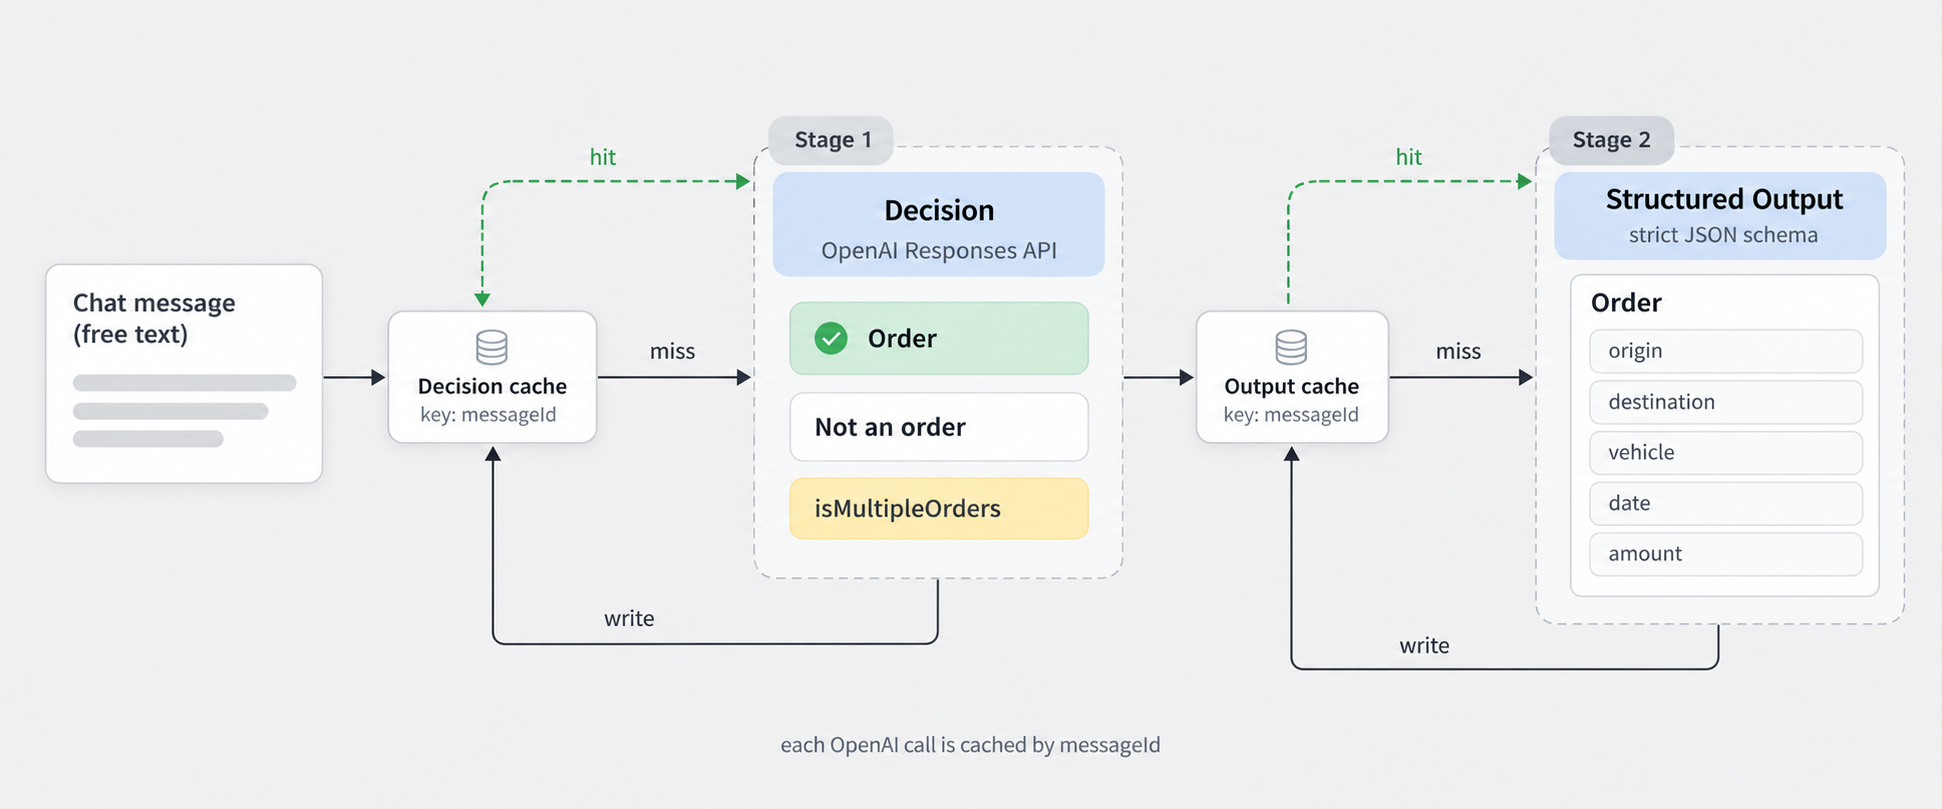
이 파이프라인은 intent(메시지 의도) 판정과 초안 생성을 별도 호출로 나눴습니다. 먼저 분류 API가 메시지 구간을 ORDER_REQUEST, ORDER_CHANGE, DISPATCH_STATUS, CHITCHAT, OTHER 중 하나로 판정하고 오더 요청 확률을 반환했습니다. 주문 요청이 아니거나 확률이 기준보다 낮으면 변환 호출을 건너뛰었습니다.
호출을 몇 번으로 가져갈지
한 번의 호출에서 intent와 draft를 모두 생성하는 방법도 검토했습니다. 하지만 채팅방에는 오더 요청이 아닌 상태 문의나 잡담도 섞여 있었습니다. 모든 구간에서 초안 생성까지 수행하면 불필요한 변환 호출이 생길 수 있었습니다.
당시 자동 접수 흐름은 판정과 변환을 두 번의 호출로 분리했습니다. 판정 단계는 intent와 확률만 반환했고, ORDER_REQUEST로 분류된 구간만 다음 단계로 보냈습니다. 오더 요청에는 두 번째 모델 호출의 지연이 더해졌지만, 오더가 아닌 메시지에서는 초안 변환을 생략했습니다.
두 번째 호출은 Responses API의 strict JSON schema를 사용해 독립적으로 등록할 운송 건마다 draft를 만들었습니다. strict schema는 모델 응답의 구조를 지정한 JSON 형식으로 제한합니다. 여러 경유지는 한 운송에 속할 수 있으므로, 경유지 수가 아니라 독립적으로 등록할 운송 건을 초안의 기준으로 삼았습니다. 필수 정보가 빠져 있으면 값을 추측하지 않고 비워 두도록 했습니다.
strict schema는 응답을 JSON 형식으로 제한하지만 값의 사실 여부까지 보증하지는 않습니다. 서버는 결과를 검증해 오더 후보로 저장했고, 담당자가 내용을 확인한 뒤 등록했습니다.
차량 수와 오더 수를 혼동한 사례도 있었습니다. 차량 2대라는 표현을 독립 오더 2건으로 해석해 변환이 실패했습니다. 한 운송에 여러 대의 차량이 필요할 수 있었으므로, 차량 수를 오더 수로 취급하면 초안 경계가 달라졌습니다. 경유지가 여러 개여도 한 운송이면 한 draft이고, 독립적으로 등록할 운송마다 하나의 draft를 반환하도록 기준을 명시했습니다.
이 사례는 분류 결과와 오더 초안이 서로 다른 책임을 가진다는 점을 보여줬습니다. 첫 단계는 메시지가 신규 운송 요청인지 판정했고, 실제 필드와 오더 개수는 두 번째 단계에서 다뤘습니다. 차량 수와 운송 건수를 혼동한 실패는 변환 규칙으로 다뤘습니다.
판정 캐시로 반복 호출 줄이기
캐시에는 판정 결과의 intent와 확률만 뒀습니다. 키는 운송사, 판정 provider, 렌더링한 입력 내용을 기준으로 만들었고, 결과는 인스턴스 메모리에 기본 10분 동안 보관했습니다. 용량도 인스턴스당 2,000건으로 제한했습니다.
이 캐시는 초안 변환 결과를 보관하지 않았습니다. 변환에 실패하면 draft를 캐시에서 꺼내 재사용하는 대신 실패 상태와 재시도 정책을 따랐습니다. 이미 분석한 메시지의 동시 요청을 제어하는 Redis 상태와 판정 결과를 재사용하는 메모리 캐시는 목적이 달랐습니다.
4. 분석을 마친 뒤 한 번에 응답하기
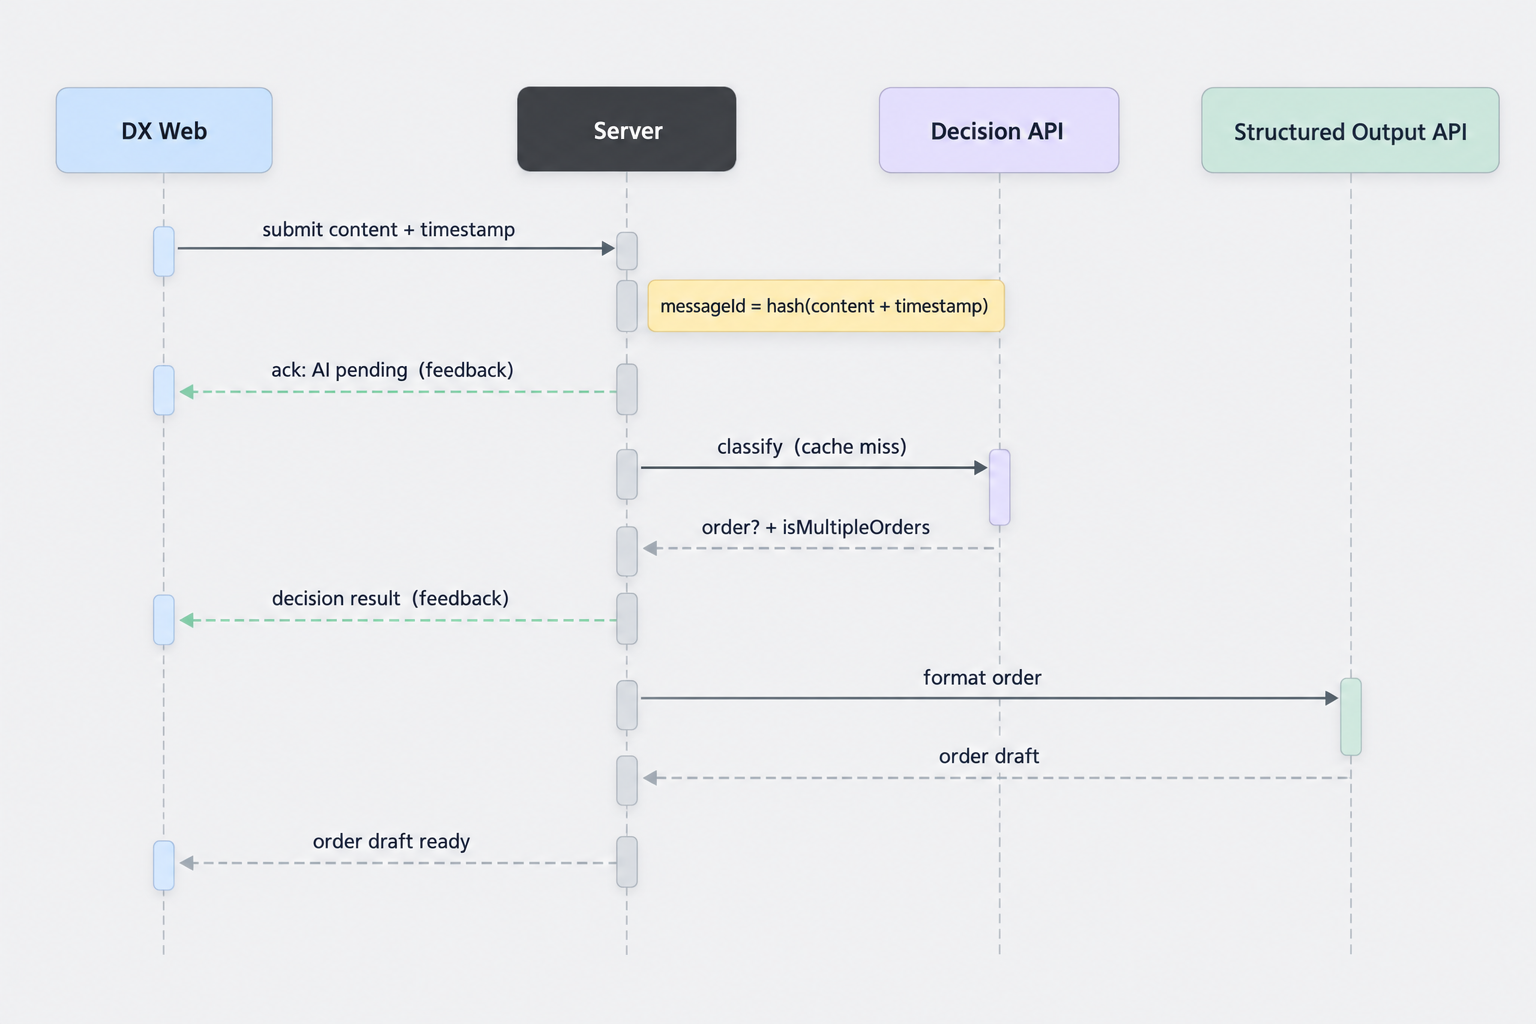
DX는 구간을 한 번 요청했고, 서버는 메시지 선점부터 판정·필요한 초안 변환·후보 저장까지 마친 뒤 결과를 응답했습니다. 당시 API는 판정 직후 접수 응답(ACK)과 변환 완료 응답을 따로 보내지 않았습니다.
오더가 아닌 메시지는 판정 결과를 반환하고 변환 API를 호출하지 않았습니다. 오더 요청은 draft 변환까지 기다린 뒤 후보 ID와 결과를 포함해 반환했습니다. 이미 다른 요청이 처리 중인 메시지에는 IN_PROGRESS를, 완료된 메시지에는 기존 상태를 응답했습니다.
5. 단계별 timeout과 처리량 분리
판정과 초안 생성은 필요한 처리량과 대기 시간이 달랐습니다. 당시 기본 설정에서 판정 요청 timeout은 3초, 변환 요청 timeout은 25초였습니다. 이 값은 응답 시간이 아니라 요청을 기다리는 상한 설정이었습니다.
서버는 판정과 변환에 별도의 동시성 제한을 뒀습니다. 연속 실패 시 해당 API 요청을 잠시 중단하는 circuit breaker도 각각 적용했습니다. 느린 draft 변환이 판정 요청 처리 용량을 모두 차지하지 않게 하기 위해서였습니다. 한 구간에서는 판정을 먼저 끝낸 뒤 변환을 기다렸고, 한 요청에 여러 오더 구간이 있으면 변환 작업을 전용 작업 풀(executor)에 제출해 처리했습니다.
6. 채널별 ID 대신 서버에서 오더를 식별하기
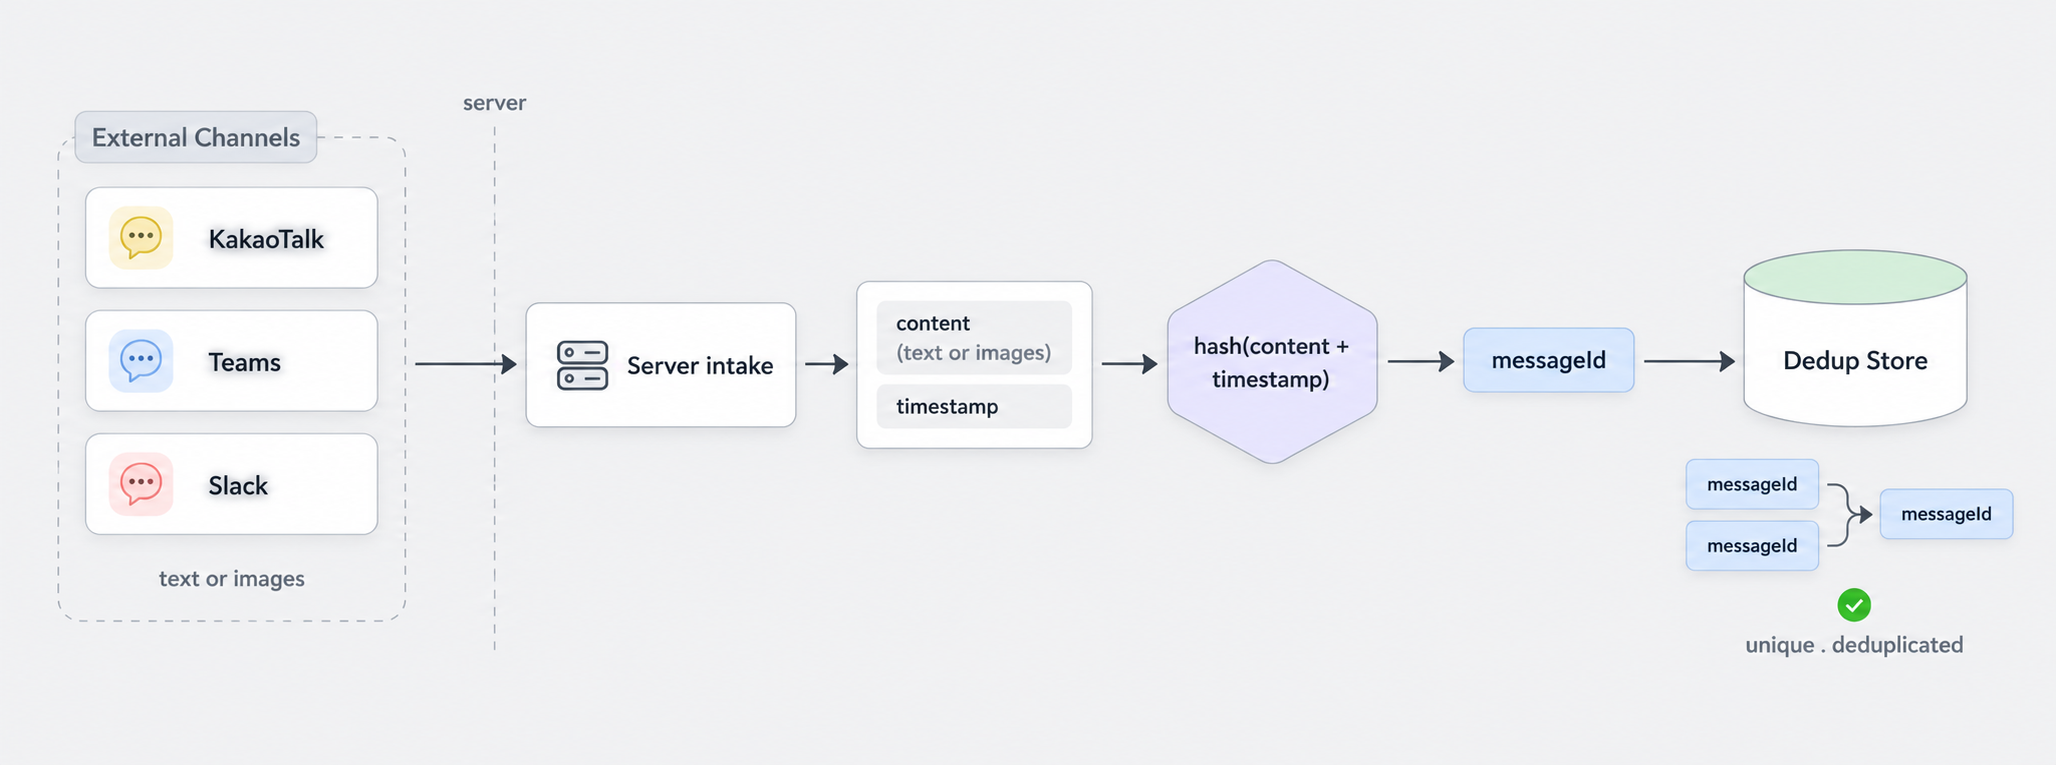
카카오톡만 처리할 때는 수집기의 ID로 메시지 구간을 만들 수 있었습니다. 하지만 Teams처럼 다른 채널을 추가하면 원본 ID를 공통 식별 기준으로 쓰기 어려웠습니다. 이 때문에 각 오더 초안의 내용과 타임스탬프를 조합해 서버가 식별자를 정하는 방향을 잡았습니다. 원본 ID는 수집과 추적에 남기고, 후보 중복 판단은 서버 식별자를 사용하도록 경계를 나누려 했습니다.
이 식별 방식은 당시 구현 전이었습니다. 오더 필드 정규화, 타임스탬프의 기준과 정밀도, 내용과 타임스탬프가 모두 같은 별개의 오더를 구분하는 규칙을 먼저 정해야 했습니다. 오더 내용은 메시지를 해석한 뒤에야 알 수 있었으므로 새 식별자는 Redis 선점 키를 그대로 대체할 수 없었습니다. 판정 전에 중복 모델 호출을 막을 키와, 판정 후 같은 오더 후보를 식별할 키는 별도로 설계해야 했습니다.
타임스탬프의 출처도 결정하지 못한 상태였습니다. 원본 채널이 제공한 타임스탬프를 쓸지, 서버가 수신하면서 기록한 타임스탬프를 쓸지에 따라 같은 오더의 식별 결과가 달라질 수 있었습니다.
당시 Redis 키와 구간 키에는 채널 종류를 구분하는 값이 포함되어 있지 않았습니다. 입력은 카카오톡뿐이었지만, Teams를 추가하면서 같은 ID 값이 들어오면 다른 채널의 메시지를 같은 키로 오인할 가능성이 있었습니다. 채널을 확장하기 전에 키에 채널 네임스페이스를 포함하거나 서버가 만드는 오더 식별자로 전환해야 했습니다.
7. 기대 오더량을 기준으로 목표 잡기
목표는 당시 건수가 아니라 적용했을 때의 기대 오더량을 기준으로 잡았습니다. 시나리오에서는 수기 접수를 월 약 300건, 중개형 3PL 고객 한 곳 적용 시 월 약 6,600건으로 추정했습니다. 그 고객은 하위 화주 수십 곳의 오더를 받아 재배차했습니다. 이런 고객과 기존 수기 고객으로 확장하면 월 5만 건, 피크 시 분당 수십 건을 처리할 수 있도록 목표를 잡았습니다. 모두 도입 범위에 따른 계획용 추정치였으며 운영 실적은 아니었습니다.
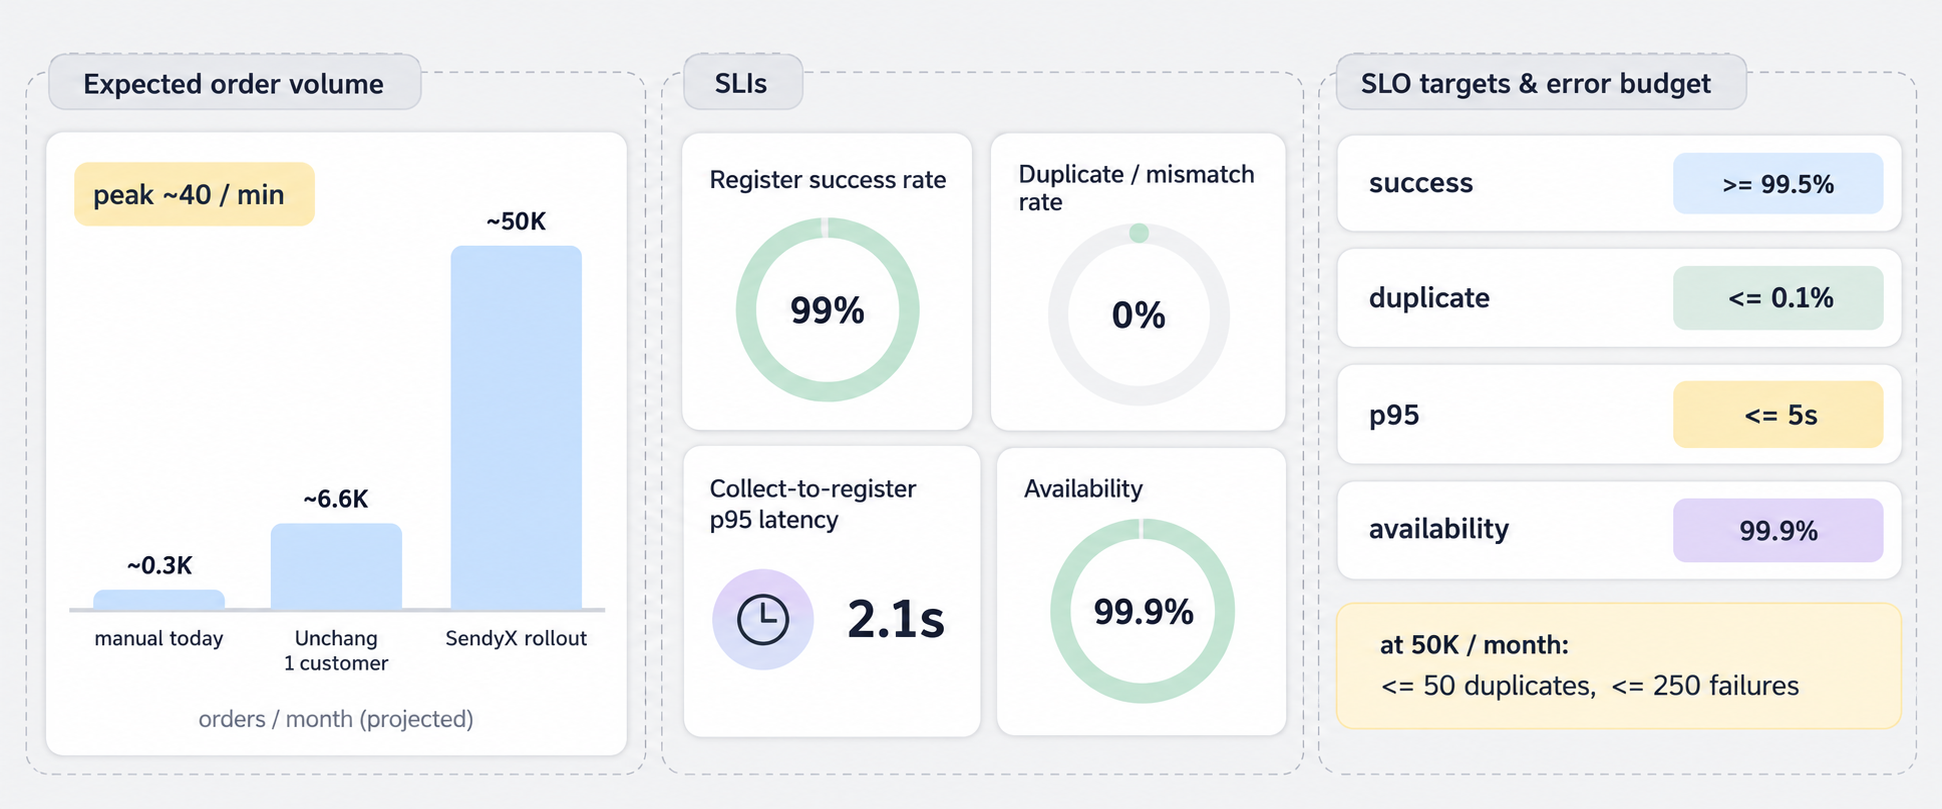
이 기대량을 바탕으로 지표와 목표를 정했습니다. SLO(서비스 수준 목표)는 후보 생성 성공률 99.5% 이상, 후보 중복·정보 불일치율 0.1% 이하, 가용성 99.9%로 제안했습니다. 월 5만 건이면 중복·불일치 0.1%는 월 50건, 후보 생성 성공률 99.5%는 월 250건의 실패 예산이었습니다.
p95는 요청 중 95%가 이 값보다 짧은 시간 안에 끝났는지를 보는 지표입니다. 측정 단위는 서버가 분석 API 요청을 받은 시점부터 모든 구간의 후보를 포함한 최종 응답을 반환할 때까지로 잡았습니다. 한 요청에 여러 구간이 있더라도 구간별 시간이 아니라 전체 응답 시간을 계산하고, 담당자 확인과 오더 등록 시간은 제외하기로 했습니다. 변환 요청 timeout은 최대 25초였으므로 지연 목표는 기준선을 측정한 뒤 정하기로 했습니다. 성공률·중복률·가용성은 제안 목표였으며, 운영 측정 결과는 없었습니다.
마치며
선택한 구조
처음 접수 자동화를 시작한 이유는 운영자가 대화를 콘솔로 옮겨 담는 수고를 줄이기 위해서였습니다. 당시 구현은 카카오톡 메시지를 분석해 후보를 만들고, 같은 메시지 구간의 동시 분석과 후보 재저장을 제어했습니다. 담당자 확인과 오더 등록은 계속 남았고, 수기 대조가 얼마나 줄었는지는 측정하지 않았습니다.
- 당시 식별: 카카오톡 수집기의
chatId와logIds로 구간을 만들고, Redis 메시지 선점과 후보 DB 키는 서로 다른 단위를 사용 - 후속 식별 설계: 채널 원본 ID에 기대지 않고 각 오더 초안의 내용과 타임스탬프를 사용해 서버에서 공통 식별자를 만들 계획이었습니다. 정규화와 동일 내용 오더 구분 규칙은 남은 과제였습니다.
- 동시성: 만료 시간이 있는 Redis 선점(lease)으로 같은 메시지의 동시 분석을 제어하고 완료·실패 상태를 분리. Redis 장애 때는 중복 분석 가능성이 남음
- AI 호출: intent를 먼저 판정하고 오더 요청에 한해서 strict schema 변환을 호출
- 캐시: 인스턴스 메모리에는 판정 결과만 저장하고 draft는 오더 후보로 저장
- 시간 제한: 판정과 변환 요청에 서로 다른 timeout과 동시성 한도를 적용
- 운영 목표: 실제 측정치와 구분해 기대 오더량 기반 SLO를 설정
남은 비용과 판단 기준
각각의 선택에는 관리 비용이 따랐습니다. 수집기가 다른 환경에서 전달한 ID가 일치하는지 확인해야 했습니다. Redis 처리 상태와 후보 DB 고유 키도 서로 다른 단위로 유지해야 했습니다. 오더 요청에서는 두 번의 모델 호출이 이어져 지연과 변환 실패도 계속 다뤄야 했습니다.
다음 편에서는 서버 상태기계의 전이 규칙, lease 만료 처리, 멱등 등록 API의 재시도 계약을 코드와 함께 다룰 예정입니다.